python利用xpath定位问题
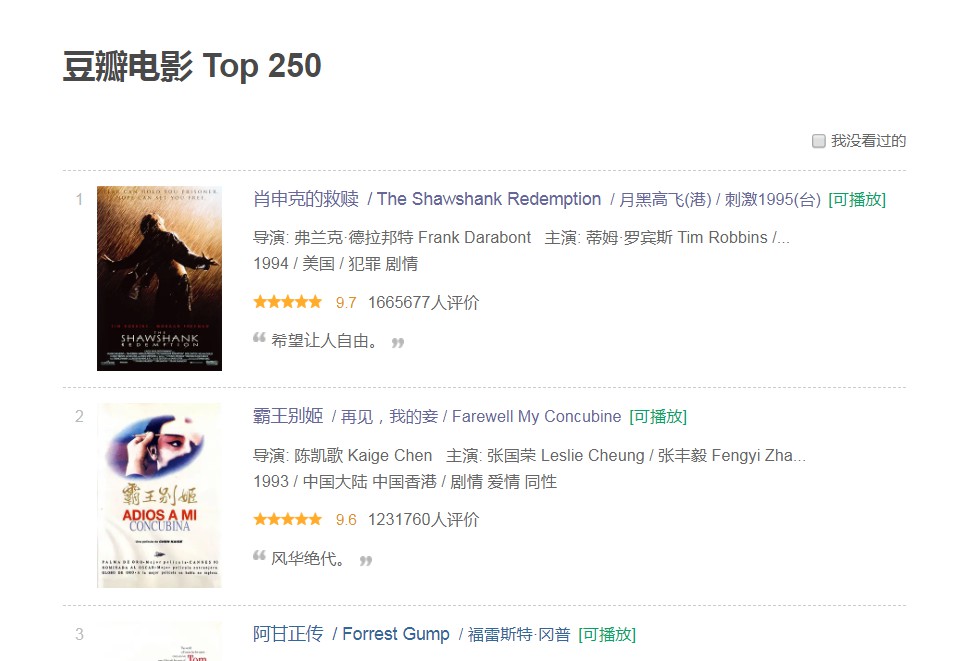
以豆瓣top250为例,xpath定位的方式是“先大后小”,即先获取到列表然后再获取单部电影的信息。
列表最一层为ol元素且有class属性,要取列表则是
1
| selector.xpath('//ol[@class="grid_view"]/li')
|
取完后,单个信息便是简单获取了只要遍历即可,如电影封面图片,电影名字,评分。。。
1
2
3
4
5
6
7
8
|
item.xpath('//img/@src')[0]
item.xpath('//div[@class="hd"]/a/text()')
item.xpath('//span[@class="rating_num"]/text()')
|
若到此也是按其xpath的路径来获取的话,获取的并不是列表里面单个电影的信息,而是网页中全部符合路径的信息,为什么?原因和简单,其主要问题在于路径定位问题。
若是改成绝对定位也是可以,如下
1
2
|
item.xpath('//*[@id="content"]/div/div[/ol/li/div/div[1]/a/img/@src')[0]
|
但是获取列表就没意义,解决办法只需要一个 . 修改之后的定位则是
1
2
3
4
5
6
7
8
|
item.xpath('.//img/@src')[0]
item.xpath('.//div[@class="hd"]/a/text()')
item.xpath('.//span[@class="rating_num"]/text()')
|
可以理解为,当前路径下开始寻找。
XPath 语法
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
|
item.xpath('//title/text()')
item.xpath('.//img/@src')
item.xpath('.//img/@alt')
item.xpath('.//img/@data-src')
item.xpath('//div[@class="jjText"]/node()')
item.xpath('.//comment()')
/ 根节点选取、或是元素和元素的过度。
//
|
xpath获取某个节点的html源码
1
2
3
4
5
6
7
8
9
10
11
| import requests
import lxml.html
import html
temp_html = requests.get('https://www.thepaper.cn/newsDetail_forward_8054822').content.decode('utf-8')
selector = lxml.html.fromstring(temp_html)
temp_txt = selector.xpath('//div[@class="news_txt"]')
temp_htmls = ''
for x in temp_txt:
temp_htmls += html.unescape(lxml.html.tostring(x).decode('utf-8'))
print(temp_htmls)
|
选取节点
XPath 使用路径表达式在 XML 文档中选取节点。节点是通过沿着路径或者 step 来选取的。
下面列出了最有用的路径表达式:
| 表达式 |
描述 |
| nodename |
选取此节点的所有子节点。 |
| / |
从根节点选取。 |
| // |
从匹配选择的当前节点选择文档中的节点,而不考虑它们的位置。 |
| . |
选取当前节点。 |
| .. |
选取当前节点的父节点。 |
| @ |
选取属性。 |
实例
在下面的表格中,我们已列出了一些路径表达式以及表达式的结果:
| 路径表达式 |
结果 |
| bookstore |
选取 bookstore 元素的所有子节点。 |
| /bookstore |
选取根元素 bookstore。注释:假如路径起始于正斜杠( / ),则此路径始终代表到某元素的绝对路径! |
| bookstore/book |
选取属于 bookstore 的子元素的所有 book 元素。 |
| //book |
选取所有 book 子元素,而不管它们在文档中的位置。 |
| bookstore//book |
选择属于 bookstore 元素的后代的所有 book 元素,而不管它们位于 bookstore 之下的什么位置。 |
| //@lang |
选取名为 lang 的所有属性。 |
谓语(Predicates)
谓语用来查找某个特定的节点或者包含某个指定的值的节点。
谓语被嵌在方括号中。
实例
在下面的表格中,我们列出了带有谓语的一些路径表达式,以及表达式的结果:
| 路径表达式 |
结果 |
| /bookstore/book[1] |
选取属于 bookstore 子元素的第一个 book 元素。 |
| /bookstore/book[last()] |
选取属于 bookstore 子元素的最后一个 book 元素。 |
| /bookstore/book[last()-1] |
选取属于 bookstore 子元素的倒数第二个 book 元素。 |
| /bookstore/book[position()<3] |
选取最前面的两个属于 bookstore 元素的子元素的 book 元素。 |
| //title[@lang] |
选取所有拥有名为 lang 的属性的 title 元素。 |
| //title[@lang=’eng’] |
选取所有 title 元素,且这些元素拥有值为 eng 的 lang 属性。 |
| /bookstore/book[price>35.00] |
选取 bookstore 元素的所有 book 元素,且其中的 price 元素的值须大于 35.00。 |
| /bookstore/book[price>35.00]/title |
选取 bookstore 元素中的 book 元素的所有 title 元素,且其中的 price 元素的值须大于 35.00。 |
选取未知节点
XPath 通配符可用来选取未知的 XML 元素。
| 通配符 |
描述 |
| * |
匹配任何元素节点。 |
| @* |
匹配任何属性节点。 |
| node() |
匹配任何类型的节点。 |
实例
在下面的表格中,我们列出了一些路径表达式,以及这些表达式的结果:
| 路径表达式 |
结果 |
| /bookstore/* |
选取 bookstore 元素的所有子元素。 |
| //* |
选取文档中的所有元素。 |
| //title[@*] |
选取所有带有属性的 title 元素。 |
选取若干路径
通过在路径表达式中使用“|”运算符,您可以选取若干个路径。
实例
在下面的表格中,我们列出了一些路径表达式,以及这些表达式的结果:
| 路径表达式 |
结果 |
| //book/title | //book/price |
选取 book 元素的所有 title 和 price 元素。 |
| //title | //price |
选取文档中的所有 title 和 price 元素。 |
| /bookstore/book/title | //price |
选取属于 bookstore 元素的 book 元素的所有 title 元素,以及文档中所有的 price 元素。 |
参考


