NoBige-JackCh3n

copy to my blog

杭州临安风之谷

由来&作用

​ 有访客发邮件询问怎么关闭某个页面(关于,标签),指定某一篇文章,之前我没有去研究,也压根没有去想过,现有人问起便寻找一下解决的方法

​ 经博主实测,本方法适用于hexo,NexT主题,valine评论插件,理论上支持所有hexo主题和所有hexo评论插件。

方法

在 预先定义的参数下添加comments 并将改之为false

例如:wwwroot\source\about\index.md #关于页面

打开编辑前,长这个样子

comments: true

添加 comments 并将改之为false

comments: false

效果

关闭前

关闭前

关闭后

关闭后

完整代码

1
2
3
4
5
---
title: about
date: 2017-10-04 22:01:42
comments: false
---

参考

澳门首家线上赌场

借口

​ 那是一个夜黑风高的晚上,楼主正在整理东芝2T硬盘,在一个角落里发现一个小小的视频,点击一看映入眼前的是图1,后面就是看了会让人赤面耳红的画面,嗯哼!“澳门首家线上赌场上线啦!@#¥%……&”,接着就是这次文章的主要角色,@#¥%论坛(宣传画面上的链接)

fbi warning

注意

为了不必要的麻烦,本文中所有文字和图片及链接都经过处理,但保持原网站的结构

为了不必要的麻烦,本文中所有文字和图片及链接都经过处理,但保持原网站的结构

为了不必要的麻烦,本文中所有文字和图片及链接都经过处理,但保持原网站的结构

列表

​ 论坛采用的典型的Discuz! X3.4程序建的,板块太多,随便点了几个就让人不能镇定自若,本着学习的态度分析了其中一个板块

Discuz! X3.4

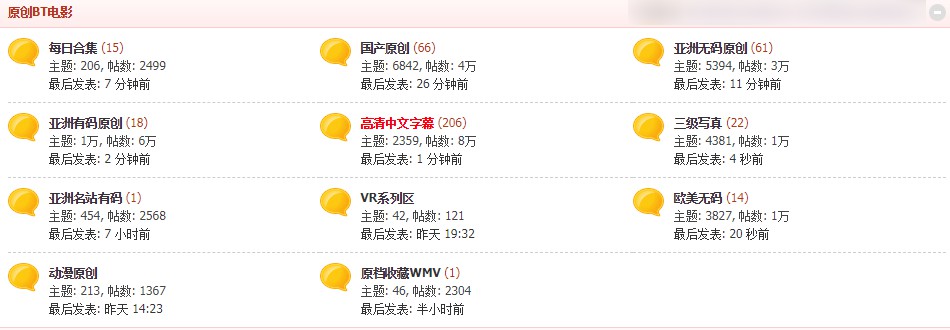
​ 板块的名称叫【原创BT电影】,是提供BT种子类型的,也利于我们用Python抓取,点了其中了【亚洲有码原创】,真的是因为文字太具有色情性质,换了一个相对而言比较好的板块截图,但是框架结构是一样的。

原创BT电影

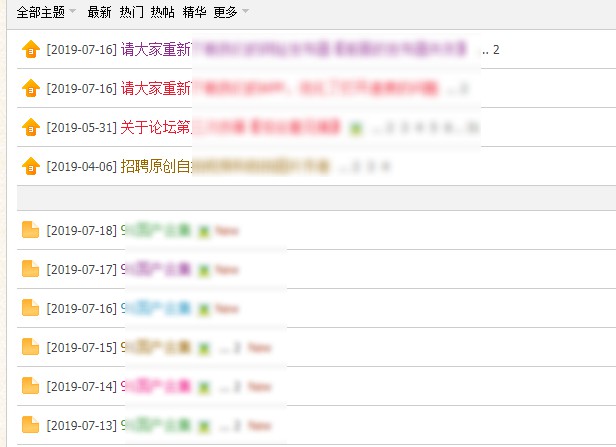
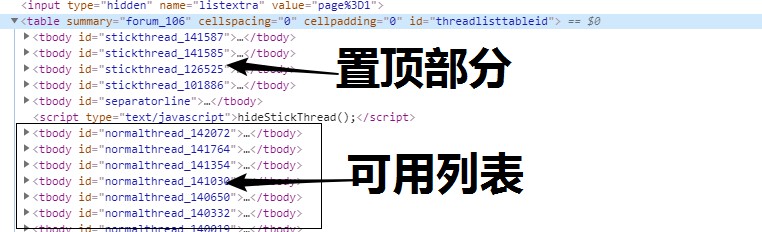
【“假”亚洲有码原创】大概长这个样子,要抓取的知识其中的非置顶部分

“假”亚洲有码原创

审核元素,发现置顶和非置顶都在一个table中,每一条信息里面的id,呈现某种我未发现的规律,怎么办法?去除呗,首先想到的是求差集,在a中但不在b中;把a中的b去除。我要的操作就是将b进行收集(参考1)

链接列表

1
2
3
def diff(listA,listB):
#求差集,在A中但不在B中;把A中的B去除
return list(set(listA).difference(set(listB)))

但是我在实际应用中并没有用到,打印类型好像不对,理论上是可行的。我用的是另外一种方法——判断,即在遍历链接列表的时候加个判断,原理和差集相似。

1
2
3
4
5
url_list_b = ['thread-141587-1-1.html','thread-141585-1-1.html','thread-126525-1-1.html','thread-126525-1-1.html']
#发布器,app,改革,招聘
for item in url_list:
temp_url = item.attrs['href']
if temp_url not in url_list_b:

对于链接列表要获取的只有【地址】,链接名(链接标题)可有可无,因为在页面里面也是可以获取具体的标题的,我还是获取下链接名。链接也是有特点的,那便是 class为“s xst”,如此遍简单了。

1
url_list = bsObj.find_all('a',{'class':'s xst'})

遍历全部的链接

1
2
3
4
5
for item in url_list:
temp_url = item.attrs['href']
if temp_url not in url_list_b:
print(item.get_text())#标题
print(temp_url)#链接

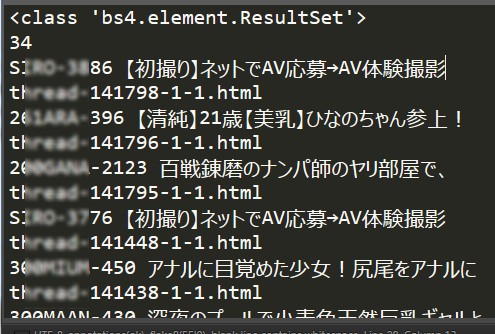
遍历效果

遍历效果

接下来则是获取具体的电影信息即可。

页面

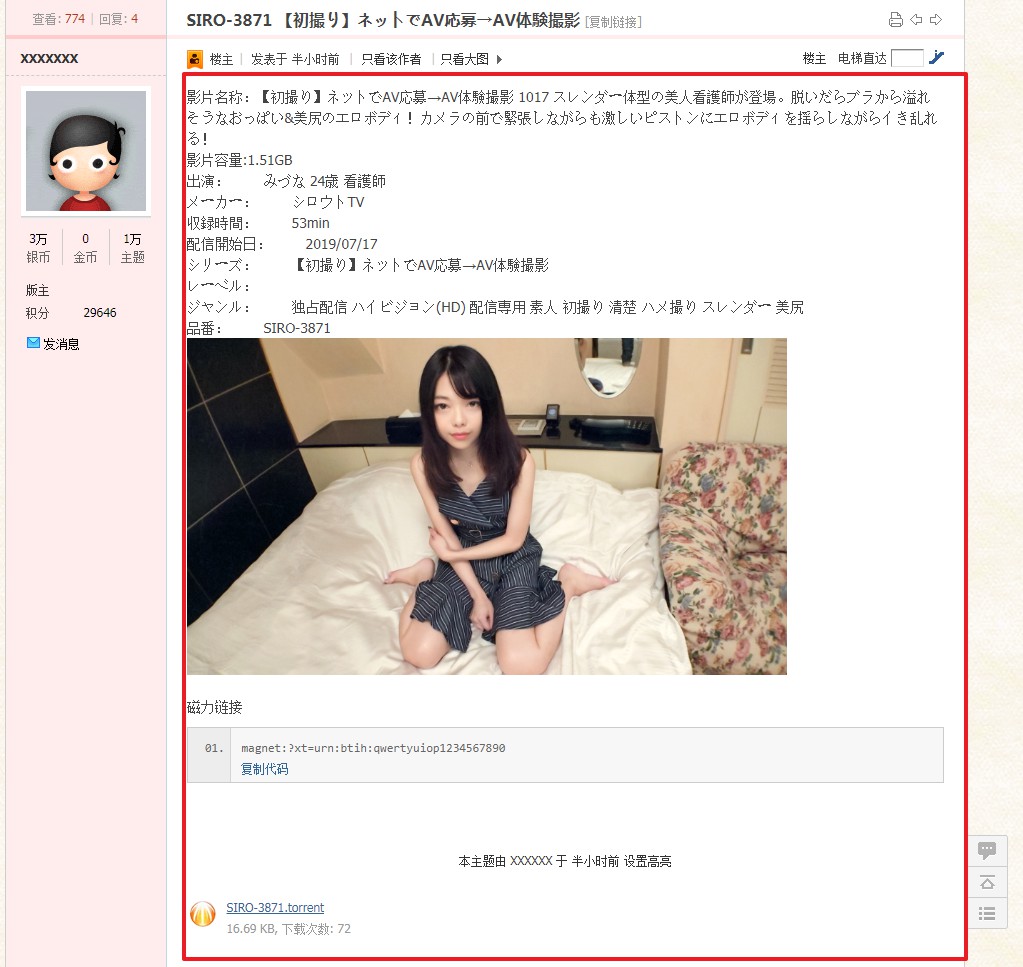
点开某个链接,页面大概长这个样子(处理过)

页面

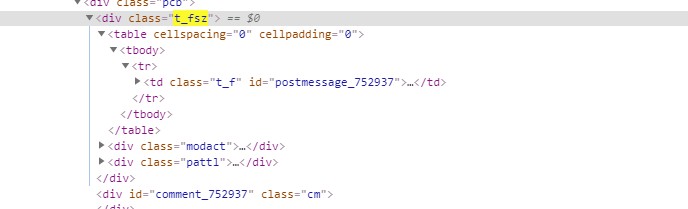
我提取了楼主发布的全部信息的html源码

楼主发布信息

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
<div class="t_fsz">
<table cellspacing="0" cellpadding="0"><tbody><tr><td class="t_f" id="postmessage_752937">
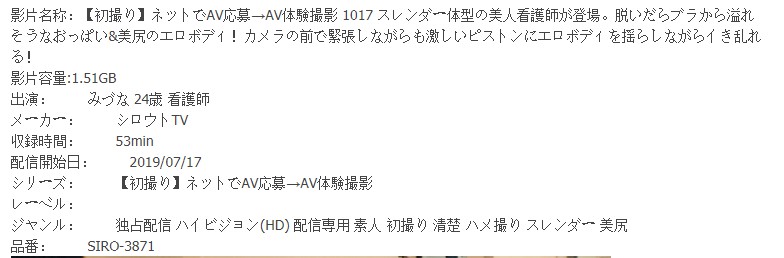
影片名称:【初撮り】ネットでAV応募→AV体験撮影 1017 スレンダー体型の美人看護師が登場。脱いだらブラから溢れそうなおっぱい&amp;美尻のエロボディ!カメラの前で緊張しながらも激しいピストンにエロボディを揺らしながらイき乱れる!<br>
影片容量:1.51GB<br>
出演:&nbsp; &nbsp; &nbsp; &nbsp; みづな 24歳 看護師<br>
メーカー:&nbsp; &nbsp; &nbsp; &nbsp; シロウトTV<br>
収録時間:&nbsp; &nbsp; &nbsp; &nbsp; 53min<br>
配信開始日:&nbsp; &nbsp; &nbsp; &nbsp; 2019/07/17<br>
シリーズ:&nbsp; &nbsp; &nbsp; &nbsp; 【初撮り】ネットでAV応募→AV体験撮影<br>
レーベル:&nbsp; &nbsp; &nbsp; &nbsp; <br>
ジャンル:&nbsp; &nbsp; &nbsp; &nbsp; 独占配信 ハイビジョン(HD) 配信専用 素人 初撮り 清楚 ハメ撮り スレンダー 美尻<br>
品番:&nbsp; &nbsp; &nbsp; &nbsp; SIRO-3871<br>
<img id="aimg_I4ET5" onclick="zoom(this, this.src, 0, 0, 0)" class="zoom" file="https://image.mgstage.com/images/shirouto/siro/3871/pb_e_siro-3871.jpg" onmouseover="img_onmouseoverfunc(this)" lazyloadthumb="1" border="0" alt="" src="https://image.mgstage.com/images/shirouto/siro/3871/pb_e_siro-3871.jpg" lazyloaded="true" width="600" height="337" style="cursor: pointer;"><br>


<br>
磁力链接<br>
<div class="blockcode"><div id="code_Ec2"><ol><li>magnet:?xt=urn:btih:qwertyuiop1234567890</li></ol></div><em onclick="copycode($('code_Ec2'));">复制代码</em></div><br>
</td></tr></tbody></table>

<div class="modact"><a href="forum.php?mod=misc&amp;action=viewthreadmod&amp;tid=142117" title="帖子模式" onclick="showWindow('viewthreadmod', this.href)">本主题由 XXXXXX 于 <span title="2019-07-18 10:42">半小时前</span> 设置高亮</a></div><div class="pattl">

<ignore_js_op>
<dl class="tattl">
<dt>
<img src="static/image/filetype/torrent.gif" border="0" class="vm" alt="">
</dt>
<dd>
<p class="attnm">

<a href="forum.php?mod=attachment&amp;aid=MTkyNzgyfDhmMDdkOGI3fDE1NjM0MjA0ODJ8MHwxNDIxMTc%3D" onmouseover="showMenu({'ctrlid':this.id,'pos':'12'})" id="aid192782" target="_blank" initialized="true">SIRO-3871.torrent</a>

</p><div class="tip tip_4" id="aid192782_menu" style="position: absolute; z-index: 301; left: 693.5px; top: 1444px; display: none;" disautofocus="true" initialized="true">
<div class="tip_c">
<p class="y"><span title="2019-07-18 10:40">半小时前</span> 上传</p>
<p>点击文件名下载附件</p>

</div>
<div class="tip_horn"></div>
</div>
<p></p>
<p>16.69 KB, 下载次数: 72</p>
<p>

</p>


</dd>
</dl>
</ignore_js_op>
</div>

</div>

又是这样一大段文字,没有任何id或者class,之前的几个爬虫我都是尽量避免和他们相见的

电影信息文字

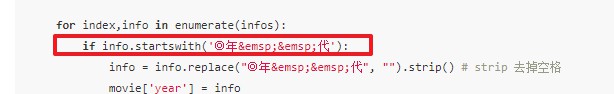
但是想起之前看的一篇爬虫文章有处理过类似的文字(参考2)其核心函数只有一个

startswith

又搜索了下 startswith 这函数得知(参考3)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
Python3 startswith()方法
Python3 字符串 Python3 字符串

描述
startswith() 方法用于检查字符串是否是以指定子字符串开头,如果是则返回 True,否则返回 False。如果参数 beg 和 end 指定值,则在指定范围内检查。

语法
startswith()方法语法:

str.startswith(substr, beg=0,end=len(string));
参数
str -- 检测的字符串。
substr -- 指定的子字符串。
strbeg -- 可选参数用于设置字符串检测的起始位置。
strend -- 可选参数用于设置字符串检测的结束位置。
返回值
如果检测到字符串则返回True,否则返回False。

​ 如此一来一大段文字也不是没有解决的办法了,先将其字符串替换成统一,去掉不必要的字符,最后再分组即可。我在其中还发现了一个有意思的地方那便是中文,英文,日文状态下的冒号完全不同,中英还好理解,日文也特别还是第一次见.

​ 电影信息也是分为两个部分处理的,其1则是信息介绍,图片,磁力链接(至上到下),其2则是后来发现种子也是可以下载。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
html.encoding = 'utf-8'
bsObj = BeautifulSoup(html.text,'lxml')
if bsObj.title:
b = bsObj.find('td',{'class':'t_f'})
# print(len(b))
c = b.get_text().replace(':',':').replace(':',':').replace('\r','').split("\n")
# print(b.get_text())
#种子
torrent = b.select('a[target="_blank"]')
if torrent:
torrent = torrent[0].attrs['href']
# print(torrent)

#图片
image = b.find_all('img')
images = []
for item in image:
images.append(item.attrs['file'])
# print(images)

#影片信息
movie_info = {}
for item in c:
if item.startswith('影片名称:'):
# print(item.replace('影片名称:',""))
movie_info['name'] = item.replace('影片名称:',"")

if item.startswith('影片容量:'):
movie_info['size'] = (item.replace('影片容量:',""))

if item.startswith('出演:'):
movie_info['star'] = (item.replace('出演:        ',""))

if item.startswith('収録時間:'):
movie_info['Rtime'] = (item.replace('収録時間:        ',""))

if item.startswith('シリーズ:'):
movie_info['series'] = (item.replace('シリーズ:        ',""))

if item.startswith('レーベル:'):
movie_info['lable'] = (item.replace('レーベル:        ',""))

if item.startswith('ジャンル:'):
movie_info['schools'] = (item.replace('ジャンル:        ',""))

if item.startswith('品番:'):
movie_info['code'] = (item.replace('品番:        ',""))

if item.startswith('magnet:'):
movie_info['magnet'] = (item.replace('复制代码',""))
if item.startswith('磁力链接 '):
movie_info['magnet'] = (item.replace('复制代码',"").replace('磁力链接 ',''))
movie_info['torrent'] = 'https://www.baidu.com/'+torrent
movie_info['images'] = images

和参考2不同的是我是直接获取text之后在进行处理,所以对空格 用&nbsp是不能替换的,尝试过加双引号也未果,便只能用复制空格替换了,其实trim应该也是可以的吧。

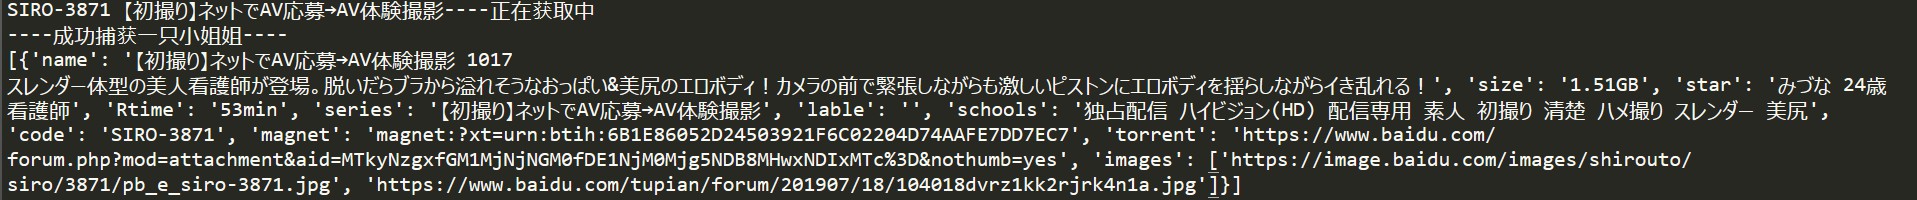
最终运行结果(演示,只抓取一个链接)

最终运行结果

代码

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
# -*-coding:utf-8-*-
import requests
import re
from bs4 import BeautifulSoup
#求差集,在A中但不在B中;把A中的B去除
def diff(listA,listB):
return list(set(listA).difference(set(listB)))
#获取电影列表
def get_page(url,movie_list):
headers = {'user-agent': 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/74.0.3729.169 Safari/537.36'}
proxies = {"http": "http://127.0.0.1:1080", "https": "127.0.0.1:1080"}
html = requests.get(url,headers=headers, proxies=proxies)
# html = requests.get(url,headers=headers)
try:
html.encoding = 'utf-8'
bsObj = BeautifulSoup(html.text,'lxml')
url_list = bsObj.find_all('a',{'class':'s xst'})#获取全部链接
print(str(type(url_list)))
print(len(url_list))
# print(url_list)
url_list_b = ['thread-141587-1-1.html','thread-141585-1-1.html','thread-126525-1-1.html','thread-101886-1-1.html']
#发布器,app,改革,招聘
for item in url_list:
temp_url = item.attrs['href']
if temp_url not in url_list_b:
print(item.get_text()+'----正在获取中')#标题
# print(temp_url)#链接
movie_list.append(html_de_link('https://www.baidu.com/'+temp_url))
print('----成功捕获一只小姐姐----')
except ArithmeticError as e:
return None
#获取电影下载链接
def html_de_link(url):
headers = {'user-agent': 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/74.0.3729.169 Safari/537.36'}
proxies = {"http": "http://127.0.0.1:1080", "https": "127.0.0.1:1080"}
html = requests.get(url,headers=headers, proxies=proxies)
try:
html.encoding = 'utf-8'
bsObj = BeautifulSoup(html.text,'lxml')
if bsObj.title:
b = bsObj.find('td',{'class':'t_f'})
# print(len(b))
c = b.get_text().replace(':',':').replace(':',':').replace('\r','').split("\n")
# print(c)
#种子
torrent = b.select('a[target="_blank"]')
if torrent:
torrent = torrent[0].attrs['href']
# print(torrent)

#图片
image = b.find_all('img')
images = []
for item in image:
images.append(item.attrs['file'])
# print(images)

#影片信息
movie_info = {}
for item in c:
if item.startswith('影片名称:'):
# print(item.replace('影片名称:',""))
movie_info['name'] = item.replace('影片名称:',"")

if item.startswith('影片容量:'):
movie_info['size'] = (item.replace('影片容量:',""))

if item.startswith('出演:'):
movie_info['star'] = (item.replace('出演:        ',""))

if item.startswith('収録時間:'):
movie_info['Rtime'] = (item.replace('収録時間:        ',""))

if item.startswith('シリーズ:'):
movie_info['series'] = (item.replace('シリーズ:        ',""))

if item.startswith('レーベル:'):
movie_info['lable'] = (item.replace('レーベル:        ',""))

if item.startswith('ジャンル:'):
movie_info['schools'] = (item.replace('ジャンル:        ',""))

if item.startswith('品番:'):
movie_info['code'] = (item.replace('品番:        ',""))

if item.startswith('magnet:'):
movie_info['magnet'] = (item.replace('复制代码',""))
if item.startswith('磁力链接 '):
movie_info['magnet'] = (item.replace('复制代码',"").replace('磁力链接 ',''))
movie_info['torrent'] = 'https://www.baidu.com/'+torrent
movie_info['images'] = images
return movie_info
# print(movie_info)
# return bsObj.find('td',{'style':'WORD-WRAP: break-word'}).a.attrs['href']
# else:
# return None
except ArithmeticError as e:
print(e)


if __name__ == '__main__':
movie_list=[]
for i in range(1,2):
get_page('https://www.baidu.com/forum-37-'+str(i)+'.html',movie_list)
print(movie_list)
# get_page('http://localhost:8080/list.html',movie_list)
# html_de_link('http://localhost:8080/page.html')

问题

  1. 昨天(7-17)写的时候出现日语乱码的现象,今天再试未能复现

  2. 网站需要爱国上网,参考4

  3. 网站访问是真的慢,索性保存列表和页面,本地使用php server来测试

    1. cmd在目录下运行php -S localhost:8080,需要php全局变量
  4. 电影信息完全没有必要,只要获取 品番 和预览图即可,信息则是本着学习的态度去获取

最后

  • 本文和代码属于纯学习性质研究
  • 如果你通过脚本抓取了类似的信息,资源请一定要符合《当地国家地区法律法规》的情况下使用。
  • 北京第三区交通委提醒您:道路千万条,安全第一条。飙车一时爽,一直飙一直爽。

参考

  1. @bitcarmanlee - python 两个list 求交集,并集,差集 - bitcarmanlee的博客 - CSDN博客
  2. @Dwyane_Coding - Python爬取电影天堂 - 掘金
  3. Python3 startswith()方法 | 菜鸟教程
  4. 高级用法 — Requests 2.18.1 文档

python

借口

​ 《高清MP4吧》的链接都是磁力链接,要么就是种子,对于python调用迅雷很不友好,于是找到著名的站点《电影天堂》,电影天堂的链接都是FTP格式的而且只能用于迅雷下载,正好符合我用迅雷来下载电影的需求

​ 电影天堂比高清MP4吧多了一个APP,而且APP都是Json格式传输数据的,减少不少的代码量,但是本着学习的态度还是写了两套方案,防止某天接口被封了。抓取页面也用了两种方式,1BeautifulSoup,2正则(写的一手烂正则)能力有限未能破解x-header-request-key 的生成规则

Python

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
# -*-coding:gb18030-*-
import requests
import re

from bs4 import BeautifulSoup
#获取电影列表
def get_page(url,movie_list):
headers = {'user-agent': 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/74.0.3729.169 Safari/537.36'}
html = requests.get(url,headers=headers)
try:
html.encoding = 'gb18030'
bsObj = BeautifulSoup(html.text,'lxml')
for i in bsObj.find_all('a',{'class':'ulink'}):
print(i.get_text())
link = html_de_link('https://www.ygdy8.net'+i.attrs['href'])
# print('https://www.ygdy8.net'+i.attrs['href'])
if link:
movie_list.append({i.get_text():link})
except ArithmeticError as e:
return None
#获取电影下载链接
def html_de_link(url):
headers = {'user-agent': 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/74.0.3729.169 Safari/537.36'}
html = requests.get(url,headers=headers)
try:
html.encoding = 'gb18030'
bsObj = BeautifulSoup(html.text,'lxml')
if bsObj.title:
return bsObj.find('td',{'style':'WORD-WRAP: break-word'}).a.attrs['href']
else:
return None
except ArithmeticError as e:
print(e)
#用正则匹配
def html_de_link_regex(url):
headers = {'user-agent': 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/74.0.3729.169 Safari/537.36'}
html = requests.get(url,headers=headers)
try:
html.encoding = 'gb18030'
pattern = re.compile(r'ftp+://[^s]*(avi|rmvb|mp4|mov|flv|wmv|mkv)')
# url = pattern.search(html.text).group(0)
print(pattern.search(html.text).group())
except ArithmeticError as e:
print(e)
# get_page('https://www.ygdy8.net/html/gndy/dyzz/list_23_1.html')
# pattern = re.compile(r'ftp+://[^s]*(avi|mpeg|rmvb|mp4|mov|flv|wmv|mkv)')
# str = ''
# print(pattern.search(str))
# html_de_link('https://www.ygdy8.net/html/gndy/dyzz/20190702/58768.html')
# html_de_link_regex('https://www.ygdy8.net/html/gndy/dyzz/20190702/58768.html')
if __name__ == '__main__':
movie_list=[]
for i in range(1,2):
get_page('https://www.ygdy8.net/html/gndy/dyzz/list_23_'+str(i)+'.html',movie_list)
print(movie_list)

API

电影列表

URL http://m.dydytt.net:8080/adminapi/api/movieList.json?categoryId=9&page=1&searchContent=

  • page - 页面

  • categoryId - 分类

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
categoryDtoList": [{

"name": "最新电影"
}, {
"id": 10,
"name": "综合电影"
}, {
"id": 1,
"name": "华语电影"
}, {
"id": 2,
"name": "欧美电影"
}, {
"id": 3,
"name": "日韩电影"
}, {
"id": 4,
"name": "华语电视"
}, {
"id": 5,
"name": "欧美电视"
}, {
"id": 6,
"name": "日韩电视"
}, {
"id": 7,
"name": "综艺"
}, {
"id": 8,
"name": "动漫"
}]

请求头

1
2
3
4
5
6
7
8
GET /adminapi/api/movieList.json?categoryId=9&page=1&searchContent= HTTP/1.1
x-header-request-timestamp: 1562565140
x-header-request-imei:
x-header-request-key: 68134c60606fa1677e43b080aced00c8
Host: m.dydytt.net:8080
Accept-Encoding: gzip
User-Agent: okhttp/3.8.0
Connection: keep-alive

返回

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
{
"total": 3000,
"rows": [{
"id": 24304,
"categoryId": 9,
"name": "2019年科幻战争《狼之歌》BD中英双字幕",
"publishTime": "2019-07-05"
}, {
"id": 24305,
"categoryId": 9,
"name": "2018年高分获奖《大象席地而坐》BD国语中字",
"publishTime": "2019-07-05"
}, {
"id": 24303,
"categoryId": 9,
"name": "2018年高分获奖《恐怖分子的孩子》BD中英双字幕",
"publishTime": "2019-07-04"
}, {
"id": 24302,
"categoryId": 9,
"name": "2019年剧情音乐《少年追梦情》BD中英双字幕",
"publishTime": "2019-07-04"
}, {
"id": 24288,
"categoryId": 9,
"name": "2019年动作《恶人传》BD韩语中字",
"publishTime": "2019-07-02"
}, {
"id": 24287,
"categoryId": 9,
"name": "2019年剧情传记《最佳敌人》BD中英双字幕",
"publishTime": "2019-07-02"
}, {
"id": 24286,
"categoryId": 9,
"name": "2019年战争剧情《余波/敌人妻》BD中英双字幕",
"publishTime": "2019-07-01"
}, {
"id": 24281,
"categoryId": 9,
"name": "2019年科幻动作《阿丽塔:战斗天使》BD中英双字幕",
"publishTime": "2019-06-30"
}, {
"id": 24279,
"categoryId": 9,
"name": "2019年动作《夏福特/杀戮战警2》BD中英双字幕",
"publishTime": "2019-06-29"
}, {
"id": 24278,
"categoryId": 9,
"name": "2019年喜剧动作《如珠如宝的人生》HD国粤双语中字",
"publishTime": "2019-06-29"
}, {
"id": 24276,
"categoryId": 9,
"name": "2019年悬疑动作《反贪风暴4》BD国粤中英双字",
"publishTime": "2019-06-28"
}, {
"id": 24274,
"categoryId": 9,
"name": "2019年奇幻动作《雷霆沙赞!》BD中英双字幕",
"publishTime": "2019-06-27"
}, {
"id": 24273,
"categoryId": 9,
"name": "2019年剧情《野马》BD中英双字幕",
"publishTime": "2019-06-27"
}, {
"id": 24272,
"categoryId": 9,
"name": "2019年剧情爱情《之后》BD中英双字幕",
"publishTime": "2019-06-27"
}, {
"id": 24268,
"categoryId": 9,
"name": "2019年惊悚恐怖《宠物坟场》BD中英双字幕",
"publishTime": "2019-06-26"
}, {
"id": 24271,
"categoryId": 9,
"name": "2017年动作战争《怒战狂心》BD俄语中字",
"publishTime": "2019-06-26"
}, {
"id": 24267,
"categoryId": 9,
"name": "2019年剧情《蜂鸟计划》BD中英双字幕",
"publishTime": "2019-06-24"
}, {
"id": 22870,
"categoryId": 9,
"name": "2017年剧情爱情《昼颜电影版》BD国日双语中字",
"publishTime": "2019-06-24"
}, {
"id": 24262,
"categoryId": 9,
"name": "2018年悬疑剧情《一个母亲的复仇》BD中字",
"publishTime": "2019-06-22"
}, {
"id": 24261,
"categoryId": 9,
"name": "2018年悬疑剧情《完美的他人》BD韩语中字",
"publishTime": "2019-06-22"
}, {
"id": 24256,
"categoryId": 9,
"name": "2019年惊悚《极端邪恶/极恶人魔》BD中英双字幕",
"publishTime": "2019-06-21"
}, {
"id": 24252,
"categoryId": 9,
"name": "2019年奇幻冒险《小飞象》BD中英双字幕",
"publishTime": "2019-06-20"
}, {
"id": 24246,
"categoryId": 9,
"name": "2019年动作喜剧《谋杀疑云》BD中英双字幕",
"publishTime": "2019-06-17"
}, {
"id": 24238,
"categoryId": 9,
"name": "2018年剧情冒险《米娅和白狮》BD中英双字幕",
"publishTime": "2019-06-16"
}, {
"id": 24237,
"categoryId": 9,
"name": "2019年科幻惊悚《惊天复制》BD中英双字幕",
"publishTime": "2019-06-16"
}, {
"id": 24234,
"categoryId": 9,
"name": "2019年悬疑惊悚《教授与疯子》BD中英双字幕",
"publishTime": "2019-06-15"
}, {
"id": 24233,
"categoryId": 9,
"name": "2018年奇幻喜剧《这个男人来自疯狂世界》BD中英双字幕",
"publishTime": "2019-06-15"
}, {
"id": 24231,
"categoryId": 9,
"name": "2019年悬疑动作《雪暴》HD国语中英双字",
"publishTime": "2019-06-14"
}, {
"id": 24230,
"categoryId": 9,
"name": "2018年获奖剧情《逆流大叔》BD国粤双语中字",
"publishTime": "2019-06-14"
}, {
"id": 24226,
"categoryId": 9,
"name": "2019年高分剧情爱情《五尺天涯》BD中英双字幕",
"publishTime": "2019-06-12"
}]
}

电影信息

URL http://m.dydytt.net:8080/adminapi/api/movieDetail.json?categoryId=9&movieDetailId=24304

  • categoryId - 分类
  • movieDetailId - 电影ID

请求头

1
2
3
4
5
6
7
8
GET /adminapi/api/movieDetail.json?categoryId=9&movieDetailId=24304 HTTP/1.1
x-header-request-timestamp: 1562565148
x-header-request-imei:
x-header-request-key: 476324e92fbd9fe590f36ecabc1ebde7
Host: m.dydytt.net:8080
Accept-Encoding: gzip
User-Agent: okhttp/3.8.0
Connection: keep-alive

返回

1
2
3
4
5
6
7
8
9
10
{
"id": 24304,
"categoryId": 9,
"name": "2019年科幻战争《狼之歌》BD中英双字幕",
"publishTime": "2019-07-05",
"homePicUrl": "https://extraimage.net/images/2019/07/05/3fab8a0e36ef4c074b299dfa2dec60de.jpg",
"content": "◎译  名 狼之歌\r\n◎片  名 Le chant du loup / The Song of the Wolf / The Wolf's Call\r\n◎年  代 2019\r\n◎产  地 法国\r\n◎类  别 战争/灾难/科幻\r\n◎语  言 法语\r\n◎字  幕 中英双字幕\r\n◎上映日期 2019-02-20(法国)\r\n◎IMDb评分 7.2/10 from 2861 users\r\n◎豆瓣评分 7.1/10 from 106 users\r\n◎文件格式 x264 + aac\r\n◎视频尺寸 1280 x 720\r\n◎文件大小 1CD\r\n◎导  演 Antonin Baudry\r\n◎编  剧 Antonin Baudry\r\n◎主  演 弗朗索瓦·西维尔 François Civil\r\n      奥玛·希 Omar Sy\r\n      马修·卡索维茨 Mathieu Kassovitz\r\n      勒达·卡代布 Reda Kateb\r\n      葆拉·贝尔 Paula Beer\r\n\r\n◎标  签 战争 | 法国 | 潜艇 | 法国电影 | 2019 | 电影 | 科幻 | 剧情\r\n\r\n◎简  介 \r\n\r\n  一个年轻人有一种罕见的礼物,可以识别他听到的每一个声音。在一艘法国核潜艇上,一切都依赖于他,金耳朵。\r\n看上去绝对可靠,他犯了一个错误,让船员处于死亡的危险之中。他希望重新获得同志的信任,但他的追求会让他们陷入更加戏剧化的境地。\r\n在核威慑和错误信息的世界中,他们发现自己被困在一个无法控制的装备中。",
"pics": "https://lookimg.com/images/2019/07/05/N79so.jpg",
"downloadUrl": "magnet:?xt=urn:btih:892ca4995b3da5107bcacd4ed3af31e30b6ca04f&dn=%e9%98%b3%e5%85%89%e7%94%b5%e5%bd%b1www.ygdy8.com.%e7%8b%bc%e4%b9%8b%e6%ad%8c.BD.720p.%e4%b8%ad%e8%8b%b1%e5%8f%8c%e5%ad%97%e5%b9%95.mkv&tr=udp%3a%2f%2ftracker.opentrackr.org%3a1337%2fannounce&tr=udp%3a%2f%2fexplodie.org%3a6969%2fannounce&tr=udp%3a%2f%2fcarapax.net%3a6969%2fannounce;ftp://ygdy8:ygdy8@yg72.dydytt.net:8370/阳光电影www.ygdy8.com.狼之歌.BD.720p.中英双字幕.mkv;"
}

运行结果

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
2019年动作《恶人传》BD韩语中字
2019年剧情传记《最佳敌人》BD中英双字幕
2019年战争剧情《余波/敌人妻》BD中英双字幕
2019年科幻动作《阿丽塔:战斗天使》BD中英双字幕
2019年动作《夏福特/杀戮战警2》BD中英双字幕
2019年喜剧动作《如珠如宝的人生》HD国粤双语中字
2019年悬疑动作《反贪风暴4》BD国粤中英双字
2019年奇幻动作《雷霆沙赞!》BD中英双字幕
2019年剧情《野马》BD中英双字幕
2019年剧情爱情《之后》BD中英双字幕
2017年动作战争《怒战狂心》BD俄语中字
2019年惊悚恐怖《宠物坟场》BD中英双字幕
2019年剧情《蜂鸟计划》BD中英双字幕
2018年悬疑剧情《一个母亲的复仇》BD中字
2018年悬疑剧情《完美的他人》BD韩语中字
2019年惊悚《极端邪恶/极恶人魔》BD中英双字幕
2019年奇幻冒险《小飞象》BD中英双字幕
2019年动作喜剧《谋杀疑云》BD中英双字幕
2018年剧情冒险《米娅和白狮》BD中英双字幕
2019年科幻惊悚《惊天复制》BD中英双字幕
2019年悬疑惊悚《教授与疯子》BD中英双字幕
2018年奇幻喜剧《这个男人来自疯狂世界》BD中英双字幕
2019年悬疑动作《雪暴》HD国语中英双字
2018年获奖剧情《逆流大叔》BD国粤双语中字
2019年高分剧情爱情《五尺天涯》BD中英双字幕
[['2019年动作《恶人传》BD韩语中字', 'ftp://ygdy8:ygdy8@yg45.dydytt.net:8469/阳光电影www.ygdy8.com.恶人传.BD.720p.韩语中字.mkv'], ['2019年剧情传记《最佳敌人》BD中英双字幕', 'ftp://ygdy8:ygdy8@yg45.dydytt.net:7469/阳光电影www.ygdy8.com.最佳敌人.BD.720p.中英双字幕.mkv'], ['2019年战争剧情《余波/敌人妻》BD中英双字幕', 'ftp://ygdy8:ygdy8@yg90.dydytt.net:8565/阳光电影www.ygdy8.com.余波.BD.720p.中英双字幕.mkv'], ['2019年科幻动作《阿丽塔:战斗天使》BD中英双字幕', 'ftp://ygdy8:ygdy8@yg45.dydytt.net:5053/阳光电影www.ygdy8.com.阿丽塔:战斗天使.BD.720p.中英双字幕.mkv'], ['2019年动作《夏福特/杀戮战警2》BD中英双字幕', 'ftp://ygdy8:ygdy8@yg45.dydytt.net:8467/阳光电影www.ygdy8.com.夏福特.BD.720p.中英双字幕.mkv'], ['2019年喜剧动作《如珠如宝的人生》HD国粤双语中字', 'ftp://ygdy8:ygdy8@yg45.dydytt.net:7467/阳光电影www.ygdy8.com.如珠如宝的人生.HD.720p.国粤双语中字.mkv'], ['2019年悬疑动作《反贪风暴4》BD国粤中英双字', 'ftp://ygdy8:ygdy8@yg45.dydytt.net:6172/阳光电影www.ygdy8.com.反贪风暴4.BD.720p.国粤双语中字.mkv'], ['2019年奇幻动作《雷霆沙赞!》BD中英双字幕', 'ftp://ygdy8:ygdy8@yg45.dydytt.net:8466/阳光电影www.ygdy8.com.雷霆沙赞!.BD.720p.中英双字幕.mkv'], ['2019年剧情《野马》BD中英双字幕', 'ftp://ygdy8:ygdy8@yg45.dydytt.net:7466/阳光电影www.ygdy8.com.野马.BD.720p.中英双字幕.mkv'], ['2019年剧情爱情《之后》BD中英双字幕', 'ftp://ygdy8:ygdy8@yg90.dydytt.net:8561/阳光电影www.ygdy8.com.之后.BD.720p.中英双字幕.mkv'], ['2017年动作战争《怒战狂心》BD俄语中字', 'ftp://ygdy8:ygdy8@yg90.dydytt.net:8560/阳光电影www.ygdy8.com.怒战狂心.BD.720p.俄语中字.mkv'], ['2019年惊悚恐怖《宠物坟场》BD中英双字幕', 'ftp://ygdy8:ygdy8@yg45.dydytt.net:3217/阳光电影www.ygdy8.com.宠物坟场.BD.720p.中英双字幕.mkv'], ['2019年剧情《蜂鸟计划》BD中英双字幕', 'ftp://ygdy8:ygdy8@yg45.dydytt.net:4201/阳光电影www.ygdy8.com.蜂鸟计划.BD.720p.中英双字幕.mkv'], ['2018年悬疑剧情《一个母亲的复仇》BD中字', 'ftp://ygdy8:ygdy8@yg45.dydytt.net:8464/阳光电影www.ygdy8.com.一个母亲的复仇.BD.720p.印地语中字.mkv'], ['2018年悬疑剧情《完美的他人》BD韩语中字', 'ftp://ygdy8:ygdy8@yg45.dydytt.net:7464/阳光电影www.ygdy8.com.完美的他人.BD.720p.韩语中字.mkv'], ['2019年惊悚《极端邪恶/极恶人魔》BD中英双字幕', 'ftp://ygdy8:ygdy8@yg45.dydytt.net:8463/阳光电影www.ygdy8.com.极端邪恶.BD.720p.中英双字幕.mkv'], ['2019年奇幻冒险《小飞象》BD中英双字幕', 'ftp://ygdy8:ygdy8@yg45.dydytt.net:8462/阳光电影www.ygdy8.com.小飞象.BD.720p.中英双字幕.mkv'], ['2019年动作喜剧《谋杀疑云》BD中英双字幕', 'ftp://ygdy8:ygdy8@yg72.dydytt.net:8367/阳光电影www.ygdy8.com.谋杀疑云.BD.720p.中英双字幕.mkv'], ['2018年剧情冒险《米娅和白狮》BD中英双字幕', 'ftp://ygdy8:ygdy8@yg90.dydytt.net:8556/阳光电影www.ygdy8.com.米娅和白狮.BD.720p.中英双字幕.mkv'], ['2019年科幻惊悚《惊天复制》BD中英双字幕', 'ftp://ygdy8:ygdy8@yg45.dydytt.net:8460/阳光电影www.ygdy8.com.惊天复制.BD.720p.中英双字幕.mkv'], ['2019年悬疑惊悚《教授与疯子》BD中英双字幕', 'ftp://ygdy8:ygdy8@yg45.dydytt.net:8459/阳光电影www.ygdy8.com.教授与疯子.BD.720p.中英双字幕.mkv'], ['2018年奇幻喜剧《这个男人来自疯狂世界》BD中英双字幕', 'ftp://ygdy8:ygdy8@yg90.dydytt.net:8555/阳光电影www.ygdy8.com.这个男人来自疯狂世界.BD.720p.中英双字幕.mkv'], ['2019年悬疑动作《雪暴》HD国语中英双字', 'ftp://ygdy8:ygdy8@yg45.dydytt.net:4135/阳光电影www.ygdy8.com.雪暴.HD.720p.国语中英双字.mkv'], ['2018年获奖剧情《逆流大叔》BD国粤双语中字', 'ftp://ygdy8:ygdy8@yg90.dydytt.net:8554/阳光电影www.ygdy8.com.逆流大叔.BD.720p.国粤双语中字.mkv'], ['2019年高分剧情爱情《五尺天涯》BD中英双字幕', 'ftp://ygdy8:ygdy8@yg45.dydytt.net:3215/阳光电影www.ygdy8.com.五尺天涯.BD.720p.中英双字幕.mkv']]

问题

  1. urlopen在获取页面的时候发现只能获取部分的html源码,暂不知是什么问题,换成requests解决问题
  2. 乱码,用了requests后发现乱码,用requests.encoding指定编码解决问题
  3. 正则本地测试没有问题,网页获取后就变成这样,暂时不会解(正则没有写好的原因)
    1. ftp://ygdy8:ygdy8@yg45.dydytt.net:8469/阳光电影www.ygdy8.com.恶人传.BD.720p.韩语中字.mkv">ftp://ygdy8:ygdy8@yg45.dydytt.net:8469/阳光电影www.ygdy8.com.恶人传.BD.720p.韩语中字.mkv

参考

快速上手 — Requests 2.18.1 文档

迅雷极速版

环境

  • window7-64

  • python v3.7.0:1bf9cc5093

  • 迅雷极速版:1.0.26.296

  • 迅雷X纯净版:10.1.16.466

COM

1
2
3
4
5
from win32com.client import Dispatch
thunder = Dispatch("ThunderAgent.Agent64.1")
# AddTask("下载地址", "另存为文件名", "保存目录", "任务注释", "引用地址", "开始模式", "只从原始地址下载", "从原始地址下载线程数")
thunder.AddTask("https://nobige.cn/images/avatar.png")
thunder.CommitTasks()

CMD

1
2
3
4
5
6
7
import os,base64
url = 'https://nobige.cn/images/avatar.png'
os.chdir("D:\\xiao\\Xunlei\\Program")
def getThunderUrl(url):
return ("thunder://".encode("utf-8")+base64.b64encode(('AA'+url+'ZZ').encode("utf-8"))).decode("utf-8")
thunderUrl = getThunderUrl(url)
os.system("Thunder.exe -StartType:DesktopIcon \"%s\""%thunderUrl)

SDK

没看出个所以然来,又说好像只能支持HTTP,贴出地址

问题

  1. 磁力链接不能直接下载,还要手动点击(鼠标模拟)

  2. CMD方式的链接必须是迅雷特有的链接,或者磁力链接

  3. COM方式还需要安装pywin32,较为麻烦

    •    #安装步骤
         https://github.com/mhammond/pywin32/releases #下载对应系统和python版本的pywin32
         pip install Dispatch
         pip install pypiwin32
      

设置

  • ​ 迅雷X
    • [√]一键下载
    • [√]自动将低速任务移动至列尾
    • [√]全局下载速度低于 100 KB/s自动增加同时下载任务数
    • [√]自动修改为上次使用的目录
  • ​ 迅雷极速版
    • [√]自动修改为上次使用的目录
    • [√]开启静默下载
    • 默认下载模式为[立即下载]
    • [√]自动将低速任务移动至列尾
    • 原始地址线程数[10]

参考

使用python在迅雷中添加任务 - 知乎

用Python调用迅雷实现后台批量下载 - aRooooooba的博客 - CSDN博客

[2015.12.16]迅雷极速版1.0.33.358 纯净版–小俊博客

python

由来

​ 买了几本书,其中一本还买错了版本了,真是疏忽。本着练习的原则写了一个爬虫,代码是基于书本和搜索引擎的。

​ 只是简单的爬取了Top100的榜单,没有一些扫操作。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
from urllib.request import urlopen
from urllib.error import HTTPError
from bs4 import BeautifulSoup
def get_ranking_list(url):
try:
html = urlopen(url)
except HTTPError as e:
print(e)
try:
bsObj=BeautifulSoup(html.read(),'lxml')
movie_list=[]
for x in bsObj('dd'):
ranking = x.find('i').get_text()#排名
board_img = x.find('img',{'class':'board-img'}).attrs['data-src'].replace('@160w_220h_1e_1c','')#图片
name = x.find('p').get_text()#电影名称
star = x.find('p',{'class':'star'}).get_text().strip()#主演
release_time = x.find('p',{'class':'releasetime'}).get_text().strip()#上映时间
score = x.find('p',{'class':'score'}).get_text().strip()#评分
movie_list.append({'ranking' : ranking,'board_img' : board_img,'name' : name,'star' : star,'release_time' : release_time,'score' : score})
return movie_list
except AttributeError as e:
print(e)
if __name__ == '__main__':
ranking_lists = get_ranking_list('https://maoyan.com/board/4?offset=0')
for i in range(10,100,10):#范围10-90
ranking_lists.append(get_ranking_list('https://maoyan.com/board/4?offset='+str(i)))
print(ranking_lists)

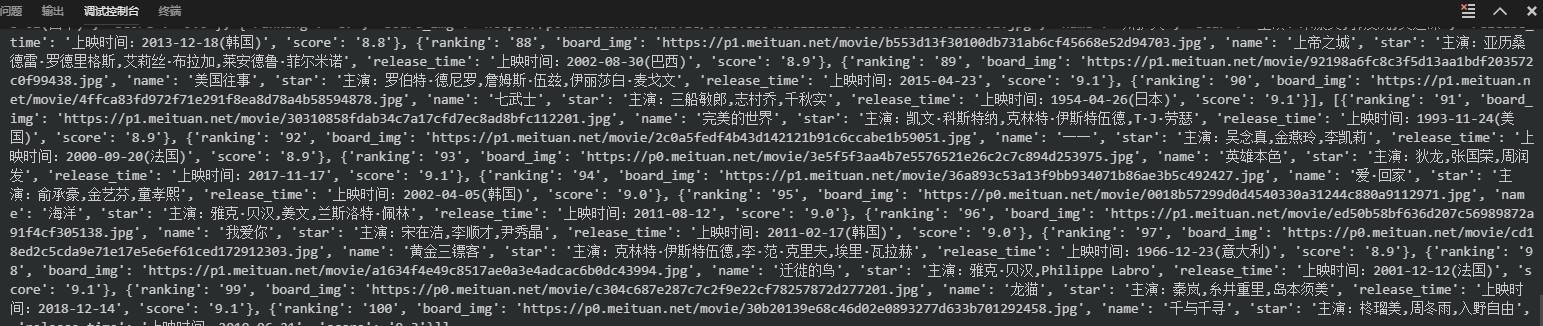
运行结果

Python利用BeautifulSoup爬猫眼Top100运行结果

知识点

  1. BeautifulSoup的简单使用
0%